
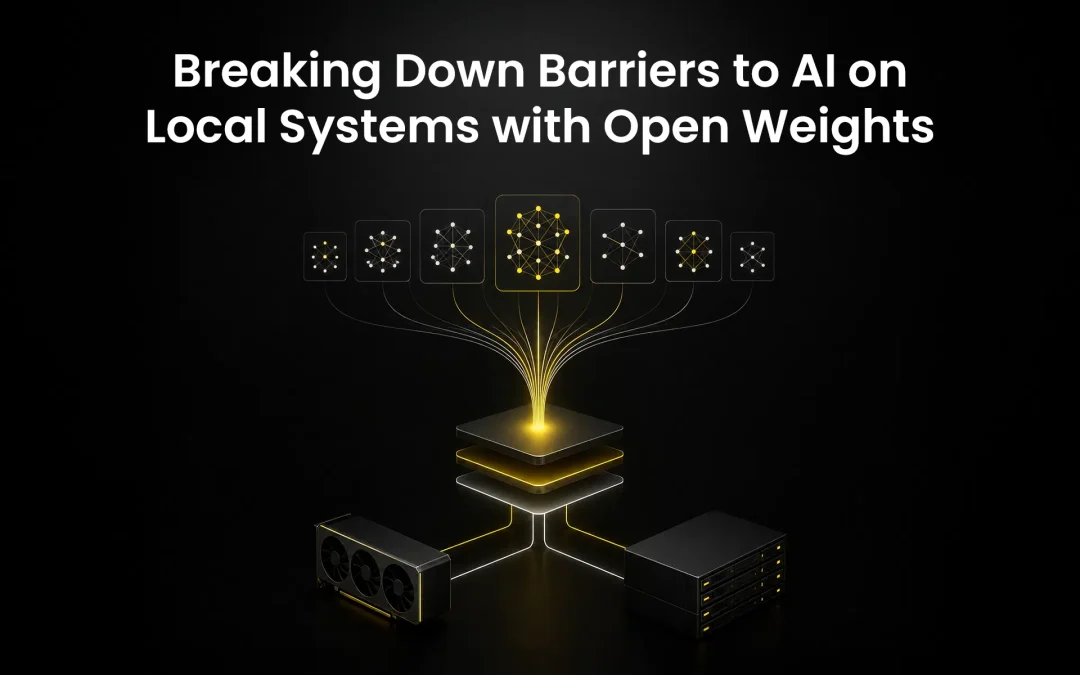
最近一封行业信函写道:“公开重量级和美国人工智能领导力,文章指出,开放权重模型(即可供下载的已训练人工智能模型)对于构建具有竞争力和广泛可及性的人工智能系统至关重要。 人工智能生态系统.
这封信的论点令人信服。开源模型使组织能够使用先进的人工智能,而无需从头开始构建模型或完全依赖专有云服务。它们为企业、大学、开发人员和公共机构提供了更大的人工智能使用选择权,以及对围绕人工智能构建的数据和专业知识的更大控制权。.
但是,获得某个模型并不一定意味着组织拥有运行该模型所需的基础设施。.
这是人工智能必须克服的下一个障碍。.
开放权重扩大了人工智能的获取途径
开放权重模型是指其学习到的参数(或权重)可供下载的模型。根据模型及其许可协议,您可以将其部署到自己的基础设施上,或针对特定任务进行定制。 微调 使用您自己的数据。.
这与开源软件并不完全相同。开放权重模型可能提供可下载的权重,但并不一定公开其训练数据、源代码或开发过程的全部内容。不过,开放权重仍然提供了一项至关重要的优势,那就是部署选择的灵活性。.
您可以选择符合您需求的模型,在本地运行,从而更好地控制您的应用程序和数据。您不必将所有提示、文档或专有数据集都发送到外部服务。.
这使得开放权重对于人工智能的隐私、主权、竞争、研究和创新至关重要。.
但选择合适的模型只是成功的一半,运行模型才是另一半,而这正是许多组织遇到意想不到的瓶颈所在。.
可下载并不总是意味着可部署。
模型的权重文件或许可以免费下载,但部署后它们仍然需要存储在某个地方。虽然模型是开源的,但系统内存并非无限,这一简单的现实决定了你实际能够运行的模型数量。.
随着人工智能模型能力的提升,其内存需求也随之增长。模型权重必须与应用程序数据、临时工作内存以及其他资源争夺空间。 KV缓存 用于在推理过程中保留上下文。. 专家混合模型(MoE模型) 即使每个代币只有一部分专家处于活跃状态,也可能包含许多专业领域的专家。.
最终,GPU 内存和系统内存都会被填满。.
这时,你的选择就非常有限了:
- 使用更小或量化程度更高的模型
- 缩短可用上下文
- 减少同时在线用户或代理的数量
- 购买价格更高的硬件
- 将工作负载迁移到云端
- 接受所需工作负载无法运行的事实
这造成了在获取先进人工智能技术和拥有使用人工智能的资源之间存在基础设施差距。.
开放获取仍需与模型评估、安全控制和负责任的治理相结合。基础设施可以提供更强大的部署控制,但这并不能使模型本身就安全。.
利用闪存扩展有效人工智能内存
Pascari aiDAPTIV™旨在弥合这一记忆差距。.
该解决方案结合了 aiDAPTIV 缓存和 aiDAPTIV 中间件,通过额外的闪存层扩展了 GPU 和系统内存。中间件负责管理 GPU 内存、系统内存和闪存中的数据,将常用数据保留在靠近计算节点的位置,同时将不常用数据移至 aiDAPTIV 缓存。.
这使得实际的本地系统能够运行比其可用 GPU 内存和 DRAM 通常所能支持的更大、更苛刻的 AI 工作负载。.
对于 MoE 模型,aiDAPTIV 可以将常用的专家信息保存在 GPU 或系统内存中,并根据需要从闪存加载其他专家信息。对于长时间运行的对话和代理工作流,闪存可以扩展键值缓存的可用容量,从而有助于保留更多上下文信息并支持更多并发活动。.
目的并非假装闪存的速度与 DRAM 或 GPU 内存一样快,因为它的速度并不快。.
价值在于权衡。某些工作负载的运行速度可能比在内存足以容纳所有工作负载的系统上慢,但它们可以在原本根本无法运行的硬件上运行。这拓宽了您可以运行的 AI 工作负载范围,而无需使用最大的可用 GPU 基础设施。.
更强的控制力需要更实用的基础设施
开放式人工智能让您可以更好地控制模型选择、定制、部署和数据。本地基础设施使您能够行使这种控制权。.
他们携手合作,就能提供帮助:
- 将专有数据保存在本地系统上
- 减少对单一模式或服务提供商的依赖
- 针对特定应用定制模型
- 支持在课堂、实验室和小型企业中开展人工智能开发。
- 在笔记本电脑、工作站、边缘系统和本地服务器上运行功能更强大的模型
- 基础设施支出应与实际工作负载需求相匹配。
但这并不能取代对云端人工智能或前沿规模基础设施的需求。不同的工作负载需要不同的方法。但你不应该被迫在封闭的云服务和小到足以适应传统内存限制的本地模型之间做出选择。.
现在你有了更多选择。.
让每个人都能平等地使用人工智能
开放权重拓宽了对高级模型的访问。但一个真正开放的人工智能生态系统需要的不仅仅是可下载的文件。它还需要运行时环境、应用程序和基础设施,以便即使预算有限,也能部署这些模型。.
这就是 aiDAPTIV 的用武之地。.
开放权重使人工智能的获取更加民主化。aiDAPTIV 使运行人工智能的能力更加民主化。.
详细了解 Pascari aiDAPTIV™.
常见问题 (FAQ):
什么是开放权重人工智能模型?
开放权重人工智能模型是指已训练好的模型,其学习到的参数(或权重)可供用户下载,从而使组织能够在其控制的基础架构上部署并可能自定义该模型。根据许可条款,用户还可以使用自己的数据对模型进行微调。开放权重提供了更大的部署选择,而无需公开模型的完整训练数据、源代码或开发过程。.
为什么开源人工智能模型对私有和本地人工智能很重要?
开源人工智能模型使组织能够在自身控制的基础设施上运行人工智能,从而减少向外部人工智能服务发送专有提示、文档和数据集的需求。本地部署可以增强数据主权、隐私、模型定制和供应商独立性,同时赋予组织对其人工智能应用更大的控制权。开放访问仍然需要适当的模型评估、安全控制和治理。.
为什么大型人工智能模型在推理过程中需要如此多的内存?
大型人工智能模型会消耗大量内存,用于存储模型权重、应用程序数据、临时工作内存以及在推理过程中保留上下文信息的键值缓存,因此总内存需求可能远超模型权重本身的大小。多属性架构还增加了另一个需要考虑的因素,因为系统必须存储和访问多个专业专家,即使每个令牌仅激活其中的一部分。.
企业应该使用规模较小的AI模型,还是增加基础设施容量?
组织应根据工作负载对模型能力、上下文长度、并发性、性能、成本和部署控制等方面的需求,在较小的模型和额外的基础设施容量之间做出选择。较小或量化程度更高的模型可以降低内存需求,但可能需要做出一些妥协。扩展基础设施可以保持对更大模型和工作负载的访问,但传统的 GPU 和系统内存会显著增加硬件成本。.
对于运行开放权重模型而言,本地 AI 是否比云端 AI 更胜一筹?
本地人工智能能够更好地控制模型和数据,而云人工智能则可以提供企业可能不愿自行购买或运营的基础设施,因此合适的架构取决于工作负载和业务需求。开放权重模型使本地部署切实可行,但本文并未将本地基础设施定位为云或前沿规模系统的通用替代方案。.
Pascari aiDAPTIV™ 如何帮助组织在本地运行更大规模的 AI 模型?
Pascari aiDAPTIV™ 通过在 GPU 内存和系统内存之外添加闪存层,扩展了有效 AI 内存容量,使本地系统能够运行原本会超出可用 GPU 内存和 DRAM 容量的 AI 工作负载。aiDAPTIV 缓存和 aiDAPTIV 内存管理中间件负责管理这些层级的数据,将常用数据保留在靠近计算的位置,同时将不常用数据移至闪存。.
aiDAPTIV 如何支持混合专家人工智能模型?
aiDAPTIV 可以通过将常用专家保存在 GPU 或系统内存中,并根据需要从闪存加载其他专家,从而支持混合专家模型,并提高可用于更大规模混合专家部署的有效容量。这种分层方法并不能使闪存等同于 DRAM 或 GPU 内存,但它可以支持那些原本会超出传统内存限制的模型。.
aiDAPTIV能否帮助人工智能系统支持更长的上下文窗口和更多并发用户?
aiDAPTIV 可以利用闪存扩展键值缓存的可用容量,帮助 AI 系统在 GPU 内存和系统内存容量受限时保留更多上下文信息并支持更多并发活动。这种方法主要针对长时间运行的对话和智能体工作流,在这些场景中,不断增长的键值缓存需求会在推理过程中对可用内存造成显著压力。.
使用闪存作为AI内存是否会降低推理性能?
使用闪存作为额外的 AI 内存层可能会带来性能上的权衡,因为闪存的延迟高于 DRAM 或 GPU 内存,但它可以使原本受内存限制的工作负载得以部署。群联电子 (Phison) 的 aiDAPTIV 正是围绕这种容量-性能权衡而设计的:某些工作负载的运行速度可能比在拥有足够高速内存的系统上运行要慢,但同时也获得了在更实用的本地基础设施上运行的能力。.
Phison 如何帮助提高开源 AI 基础设施的可访问性?
群联电子通过 Pascari aiDAPTIV™ 解决了开放式 AI 基础设施的关键瓶颈,该方案利用闪存扩展了有效内存容量,使企业能够运行更大规模、更苛刻的工作负载,而无需完全依赖前沿规模的 GPU 基础设施。该架构增强了在笔记本电脑、工作站、边缘系统和本地服务器等各种设备上的部署灵活性,同时帮助企业使基础设施支出与工作负载需求相匹配。.

 简体中文
 English
 繁體中文
 日本語
 Deutsch
 한국어