
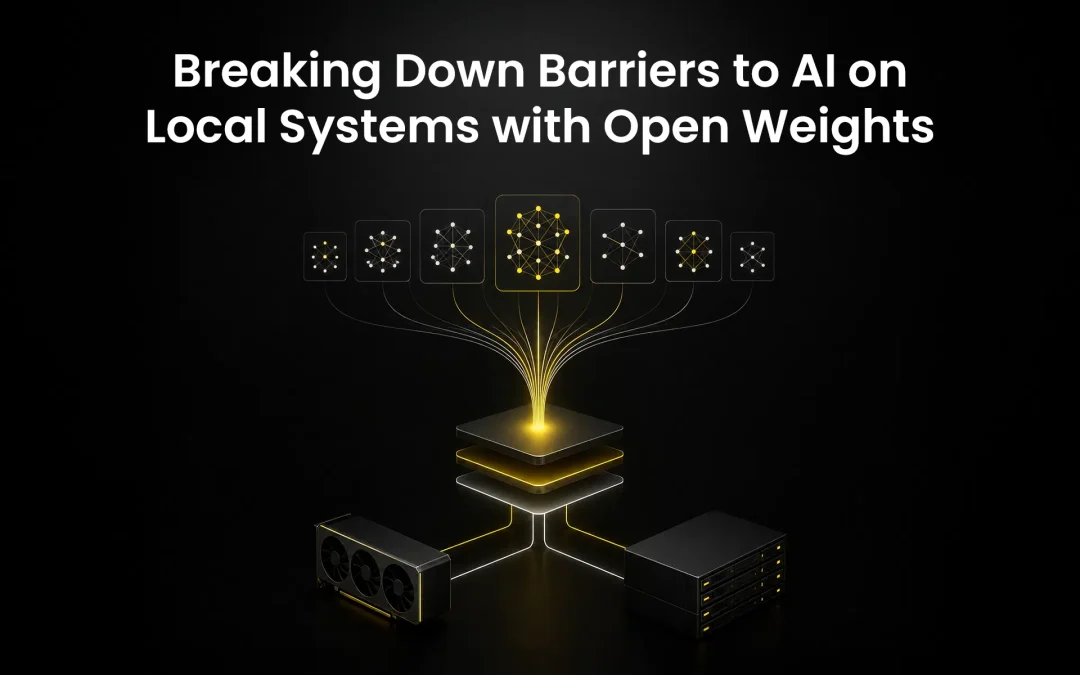
最近の業界書簡では、「“オープンウェイトとアメリカのAIリーダーシップ,オープンウェイトモデル、つまりダウンロード可能な訓練済みAIモデルは、競争力があり広く利用可能な AIエコシステム.
この書簡は説得力のある主張を展開している。オープンウェイトモデルは、組織がゼロからモデルを構築したり、独自のクラウドサービスに完全に依存したりすることなく、高度なAIを利用できるようにする。これにより、企業、大学、開発者、公共機関は、AIの利用方法においてより大きな選択肢を得ることができ、AIに関連するデータや専門知識に対するより大きな制御権を持つことができる。.
しかし、モデルを利用できるからといって、組織がそれを運用するために必要なインフラを備えているとは限らない。.
それが、AIが次に乗り越えなければならない障壁だ。.
オープンウェイトによりAIへのアクセスが拡大
オープンウェイトモデルとは、学習されたパラメータまたは重みがダウンロード可能なモデルのことです。モデルとそのライセンスによっては、独自のインフラストラクチャにデプロイしたり、特定のタスクに合わせてカスタマイズしたり、 微調整 自分のデータを使って作業します。.
これはオープンソースソフトウェアと全く同じではありません。オープンウェイトモデルは、トレーニングデータ、ソースコード、開発プロセスなど、すべての情報を公開することなく、ダウンロード可能な重みを提供する場合があります。しかし、オープンウェイトは、導入先の選択肢という、非常に重要なメリットを提供します。.
要件に合ったモデルを選択し、ローカルで実行することで、アプリケーションとデータに対するより詳細な制御が可能になります。すべてのプロンプト、ドキュメント、または独自のデータセットを外部サービスに送信する必要はありません。.
そのため、オープンウェイトは、AIのプライバシー、主権、競争、研究、イノベーションにとって重要となる。.
しかし、適切なモデルを選ぶことは、問題の半分に過ぎません。残りの半分はそれを運用することであり、多くの組織はそこで予想外の壁にぶつかるのです。.
ダウンロード可能だからといって、必ずしも展開可能とは限らない。
モデルの重みデータは無料でダウンロードできるかもしれませんが、デプロイ後はどこかに保存する必要があります。モデル自体は公開されていますが、システムメモリには限りがあり、その単純な事実が実際に実行できる内容を左右します。.
AI モデルの能力が向上するにつれて、メモリ要件も増加します。モデルの重みは、アプリケーション データ、一時作業メモリ、および KVキャッシュ 推論中に文脈を保持するために使用される。. エキスパート混合モデル(MoEモデル) 各トークンに対して活動しているのは一部の専門家のみであっても、多くの専門家が含まれている可能性がある。.
最終的には、GPUメモリとシステムメモリがいっぱいになります。.
その時点で、選択肢は限られています。
- より小型のモデル、またはより積極的に量子化されたモデルを使用する
- 利用可能なコンテキストを短縮する
- 同時ユーザー数またはエージェント数を減らす
- かなり高価なハードウェアを購入する
- ワークロードをクラウドに移行する
- 目的のワークロードは実行できないことを受け入れる
これは、高度なAIへのアクセスと、それを活用するためのリソースとの間に、インフラ面でのギャップを生み出す。.
オープンアクセスは、モデルの評価、セキュリティ管理、そして責任あるガバナンスと組み合わせる必要がある。インフラストラクチャはより高度なデプロイメント制御を可能にするが、モデルを本質的に安全にするものではない。.
フラッシュメモリによるAIの有効メモリの拡張
Pascari aiDAPTIV™は、そのメモリ不足を解消するために設計されています。.
このソリューションは、aiDAPTIVキャッシュメモリとaiDAPTIVミドルウェアを組み合わせることで、GPUメモリとシステムメモリにフラッシュメモリ層を追加し、メモリ容量を拡張します。ミドルウェアは、GPUメモリ、システムメモリ、フラッシュメモリにまたがるデータを管理し、頻繁に使用されるデータは演算処理の近くに保持する一方、使用頻度の低いデータはaiDAPTIVキャッシュメモリに移動します。.
これにより、実用的なローカルシステムにおいて、通常利用可能なGPUメモリやDRAMがサポートできる以上の、より大規模で要求の厳しいAIワークロードを実行することが可能になります。.
MoEモデルの場合、aiDAPTIVは頻繁に選択されるエキスパートをGPUまたはシステムメモリに保持しつつ、必要に応じてフラッシュメモリから他のエキスパートをロードできます。長時間の会話やエージェントワークフローでは、フラッシュメモリによってKVキャッシュの容量を拡張できるため、より多くのコンテキストを保持し、より多くの同時実行アクティビティをサポートできます。.
その目的は、フラッシュメモリがDRAMやGPUメモリと同じくらい高速であるかのように装うことではない。なぜなら、実際にはそうではないからだ。.
その価値はトレードオフにある。十分なメモリを搭載したシステムよりも処理速度が遅くなるワークロードもあるかもしれないが、本来なら処理できないようなハードウェアでも実行できる。これにより、最大規模のGPUインフラストラクチャを必要とせずに実行できるAIワークロードの範囲が広がる。.
より高度な制御には、より実用的なインフラが必要となる。
オープンウェイトAIは、モデルの選択、カスタマイズ、デプロイ、データに関して、より高度な制御を可能にします。ローカルインフラストラクチャを使用することで、その制御を自在に行うことができます。.
彼らが協力すれば、以下のことが可能になります。
- 機密データはローカルシステムに保存してください。
- 単一のモデルまたはサービスプロバイダーへの依存度を低減する
- 特殊な用途向けにモデルをカスタマイズする
- 教室、研究室、中小企業におけるAI開発を支援する
- ノートパソコン、ワークステーション、エッジシステム、オンプレミスサーバーで、より高性能なモデルを実行できます。
- インフラ投資を実際のワークロードのニーズに合わせる
こうしたことは、クラウドAIや最先端規模のインフラストラクチャの必要性をなくすものではありません。ワークロードが異なれば、必要なアプローチも異なります。しかし、閉鎖的なクラウドサービスと、従来のメモリ制限内に収まるほど小規模なローカルモデルのどちらかを選択する必要はないはずです。.
これで選択肢が増えました。.
AIを実行する能力を民主化する
オープンウェイトは高度なモデルへのアクセスを拡大します。しかし、真にオープンなAIエコシステムには、ダウンロード可能なファイル以上のものが必要です。最先端規模の予算がなくても、それらのモデルを展開できるランタイム、アプリケーション、インフラストラクチャも必要です。.
そこでaiDAPTIVの出番となるのです。.
オープンウェイトはAIへのアクセスを民主化する。aiDAPTIVはAIを実行する能力を民主化する。.
詳細はこちら Pascari aiDAPTIV™.
よくある質問(FAQ):
オープンウェイトAIモデルとは何ですか?
オープンウェイトAIモデルとは、学習済みのパラメータ(重み)をユーザーがダウンロードできるトレーニング済みモデルのことです。これにより、組織は自社が管理するインフラストラクチャ上にモデルをデプロイし、必要に応じてカスタマイズできます。ライセンス条件によっては、ユーザーは独自のデータを使用してモデルを微調整することも可能です。オープンウェイトは、モデルの完全なトレーニングデータ、ソースコード、開発プロセスを必ずしも公開することなく、より幅広いデプロイの選択肢を提供します。.
オープンウェイトAIモデルが、民間およびローカルAIにとって重要なのはなぜですか?
オープンウェイトAIモデルにより、組織は自社が管理するインフラストラクチャ上でAIを実行できるようになり、独自のプロンプト、ドキュメント、データセットを外部のAIサービスに送信する必要性が軽減されます。ローカル展開は、データ主権、プライバシー、モデルのカスタマイズ性、プロバイダーからの独立性を強化すると同時に、組織がAIアプリケーションをより詳細に制御できるようにします。オープンアクセスを実現するには、適切なモデル評価、セキュリティ管理、ガバナンスが依然として必要です。.
大規模なAIモデルは、推論時になぜこれほど多くのメモリを必要とするのでしょうか?
大規模なAIモデルは、モデルの重み、アプリケーションデータ、一時的な作業メモリ、推論中にコンテキストを保持するKVキャッシュなどにメモリを消費するため、必要なメモリ総量はモデルの重みだけのサイズを大幅に超える可能性があります。MoEアーキテクチャでは、各トークンがサブセットのみをアクティブ化する場合でも、システムは複数の専門的なエキスパートを保存してアクセスする必要があるため、さらに考慮すべき点が増えます。.
組織はより小規模なAIモデルを採用すべきか、それともインフラ容量を増強すべきか?
組織は、ワークロードの要件(モデル機能、コンテキスト長、同時実行性、パフォーマンス、コスト、デプロイメント制御など)に基づいて、より小規模なモデルと追加のインフラストラクチャ容量のどちらかを選択する必要があります。より小規模なモデル、あるいはより積極的に量子化されたモデルはメモリ需要を削減しますが、妥協が必要になる場合があります。インフラストラクチャを拡張することで、より大規模なモデルやワークロードへのアクセスを維持できますが、従来のGPUやシステムメモリではハードウェアコストが大幅に増加する可能性があります。.
オープンウェイトモデルを実行する場合、ローカルAIはクラウドAIよりも優れているのでしょうか?
ローカルAIはモデルとデータに対するより高度な制御を可能にする一方、クラウドAIは組織が自ら購入または運用したくないインフラストラクチャへのアクセスを提供するため、適切なアーキテクチャはワークロードとビジネス要件によって異なります。オープンウェイトモデルはローカル展開を実用的にしますが、この記事ではローカルインフラストラクチャをクラウドや最先端システムの普遍的な代替手段として位置付けているわけではありません。.
Pascari aiDAPTIV™は、組織がより大規模なAIモデルをローカルで実行するのにどのように役立ちますか?
Pascari aiDAPTIV™は、GPUメモリとシステムメモリに加えてフラッシュメモリ層を追加することで、AIの実効メモリ容量を拡張します。これにより、ローカルシステムで、本来であれば利用可能なGPUメモリとDRAMの容量を超えるAIワークロードを実行できるようになります。aiDAPTIVキャッシュメモリとaiDAPTIVメモリ管理ミドルウェアは、これらの層間でデータを管理し、頻繁に使用されるデータをコンピューティングデバイスの近くに保持すると同時に、使用頻度の低いデータをフラッシュメモリに移動します。.
aiDAPTIVは、エキスパート混合型AIモデルをどのようにサポートしていますか?
aiDAPTIVは、頻繁に選択されるエキスパートをGPUまたはシステムメモリに保持し、必要に応じてフラッシュメモリから他のエキスパートをロードすることで、エキスパート混合モデルをサポートし、大規模なMoE展開における実効容量を増加させます。この階層型アプローチは、フラッシュメモリをDRAMやGPUメモリと同等にするものではありませんが、従来のメモリ制限を超えるモデルを実現可能にします。.
aiDAPTIVは、AIシステムがより長いコンテキストウィンドウとより多くの同時ユーザーをサポートするのに役立つでしょうか?
aiDAPTIVは、フラッシュメモリによってKVキャッシュの容量を拡張することで、GPUメモリやシステムメモリの容量が制約となる場合に、AIシステムがより多くのコンテキストを保持し、より多くの同時実行処理をサポートできるようにします。このアプローチは、推論中にKVキャッシュの要件が増大し、利用可能なメモリに大きな負荷がかかる可能性のある、長時間の会話やエージェント型ワークフローを対象としています。.
AIメモリとしてフラッシュメモリを使用すると、推論性能は低下しますか?
フラッシュメモリをAI用の追加メモリ層として使用すると、フラッシュメモリはDRAMやGPUメモリよりもレイテンシが高いため、パフォーマンス上のトレードオフが生じる可能性がありますが、メモリ容量に制約のあるワークロードを実行できるようになります。Phisonは、この容量とパフォーマンスのトレードオフを念頭にaiDAPTIVを位置付けています。十分な高速メモリを搭載し、すべてのデータを格納するシステムよりもワークロードの実行速度が遅くなる場合もありますが、より実用的なローカルインフラストラクチャ上で実行できるというメリットが得られます。.
Phisonは、オープンウェイトAIインフラストラクチャへのアクセス性を向上させるために、どのように貢献できるでしょうか?
Phisonは、Pascari aiDAPTIV™を通じて、オープンウェイトAIインフラストラクチャにおける重要な制約に対処します。この技術は、フラッシュメモリによって実効メモリ容量を拡張することで、組織が最先端のGPUインフラストラクチャだけに頼ることなく、より大規模で要求の厳しいワークロードを実行できるようにします。このアーキテクチャは、ノートブック、ワークステーション、エッジシステム、オンプレミスサーバーなど、あらゆる環境への導入の柔軟性を高めると同時に、組織がインフラストラクチャへの投資をワークロードの要件に合わせることを支援します。.

 日本語
 English
 繁體中文
 简体中文
 Deutsch
 한국어